Qwen3-8B: компактная модель, которая умеет думать, когда нужно, и молниеносно отвечать, когда можно
Разработчики давно привыкли к дилемме: либо лёгкая модель, которая отвечает быстро, но поверхностно, либо тяжёлая, которая рассуждает глубоко, но требует дорогого железа. Alibaba решила сломать эту дихотомию. Qwen3-8B — dense-модель с 8 миллиардами параметров, которая умеет переключаться между двумя режимами. И это не просто маркетинговая фишка, а архитектурное решение, которое меняет правила игры для тех, кто встраивает LLM в реальные продукты.
Почему 8 миллиардов — это золотая середина
В семействе Qwen3 есть гиганты вроде MoE-версии на 235 млрд параметров, но именно плотная 8-миллиардная модель привлекла внимание сообщества. Причина — сочетание компактности и возможностей, которые раньше были доступны только моделям в несколько раз крупнее. Вот её ключевые характеристики:
- Архитектура: 36 слоёв, 32 головы внимания для запросов (Q) и 8 для ключей/значений (KV).
- Контекстное окно: 128 тысяч токенов — достаточно для анализа целых книг или больших логов.
- Лицензия: Apache 2.0 — можно использовать в коммерции и дообучать без отчислений.
- Обучение: 36 триллионов токенов — вдвое больше, чем у предшественника Qwen2.5.
Но самое интересное — не цифры, а то, как модель распоряжается вычислительными ресурсами.
Два режима работы: думать или не думать?
Qwen3-8B поддерживает гибридное мышление. В Thinking Mode модель выстраивает цепочку рассуждений (chain-of-thought) перед ответом. Это идеально для математики, кода, логических задач — любых сценариев, где важна точность, а скорость второстепенна. В Non-Thinking Mode ответ выдаётся практически мгновенно, без видимого процесса размышления. Пользователь сам решает, какой режим включить для каждого запроса.
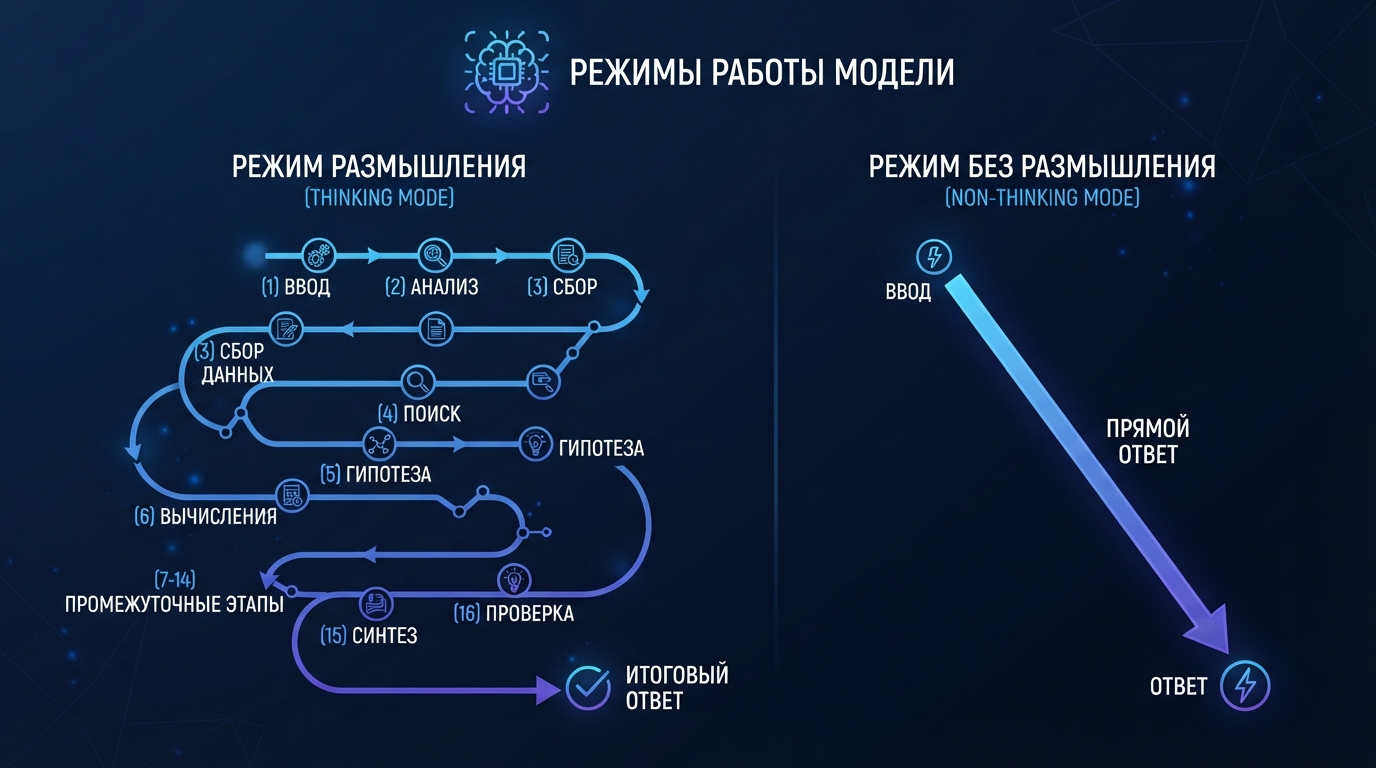
Более того, можно настроить «бюджет рассуждений» — ограничить количество токенов, которое модель потратит на размышление. Это даёт тонкий контроль: для простого вопроса модель не будет тратить время на глубокий анализ, а для сложного — не оборвёт цепочку на полпути.
Как этого добились?
Пост-тренинг Qwen3-8B проходил в четыре этапа: холодный старт на длинных цепочках рассуждений, усиление через reinforcement learning на задачах логики и кода, слияние режимов и финальное общее RL. Благодаря такому пайплайну модель научилась стабильно переключаться между режимами без потери качества.
Как попробовать Qwen3-8B прямо сейчас
Для локального запуска подойдут:
- Ollama — самый простой способ для macOS, Linux и Windows.
- LM Studio — удобный GUI для экспериментов.
- MLX — если у вас Mac на Apple Silicon.
- llama.cpp — лёгкий вариант для CPU.
- KTransformers — для тонкой настройки.
Кому это нужно?
Что дальше?
Qwen3-8B — не финальная точка, а часть тренда на «думающие» компактные модели. Если вы ищете open-weight решение, которое не требует огромных вычислительных мощностей, но даёт контроль над глубиной рассуждений, — это отличный кандидат для пилота. Загрузите модель через Ollama, протестируйте на своих задачах и решите, насколько гибридный подход оправдан в вашем проекте.